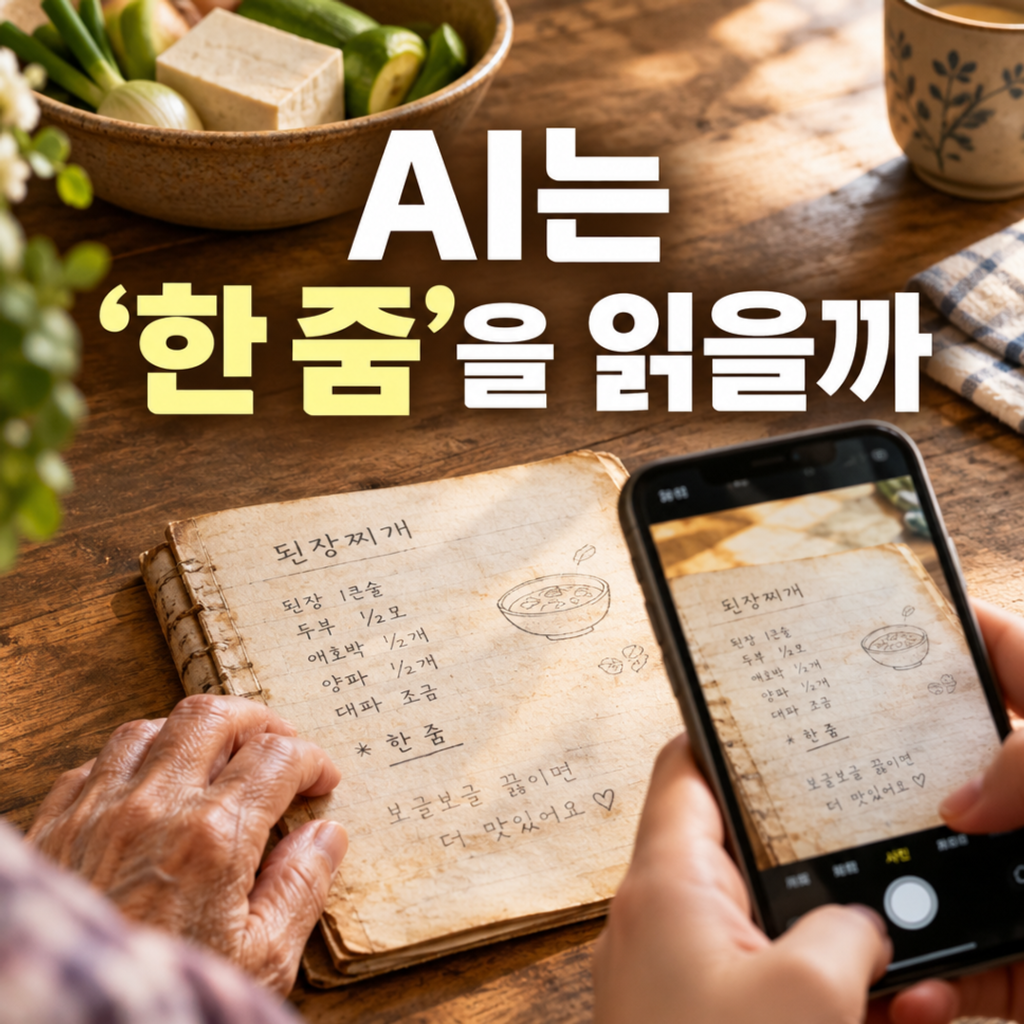
서랍 안쪽에서 오래된 종이 한 장을 꺼냈다고 상상해봅니다. 가장자리는 누렇게 변했고, 접힌 자국을 따라 글씨가 끊겨 있습니다. “고춧가루 한 줌, 마늘은 적당히.” 익숙한 문장인데도 막상 다시 읽으려니 ‘한 줌’이 어느 정도였는지, 번진 글자가 ‘간장’인지 ‘된장’인지 알 수 없습니다.
예전에는 이런 레시피를 가족 중 누군가의 기억에 기대어 다시 읽었습니다. 이제는 사진을 찍어 AI나 OCR 프로그램에 넣어볼 수도 있지요. 그런데 화면에 나타난 문장은 정말 할머니가 적은 그대로일까요? AI는 흐릿한 글자와 ‘적당히’ 같은 표현을 어떻게 읽어낼까요?
사진 속 글자를 읽기 전, 먼저 하는 일
AI가 손글씨를 읽는 과정은 사진을 곧바로 문장으로 바꾸는 일과는 조금 다릅니다.
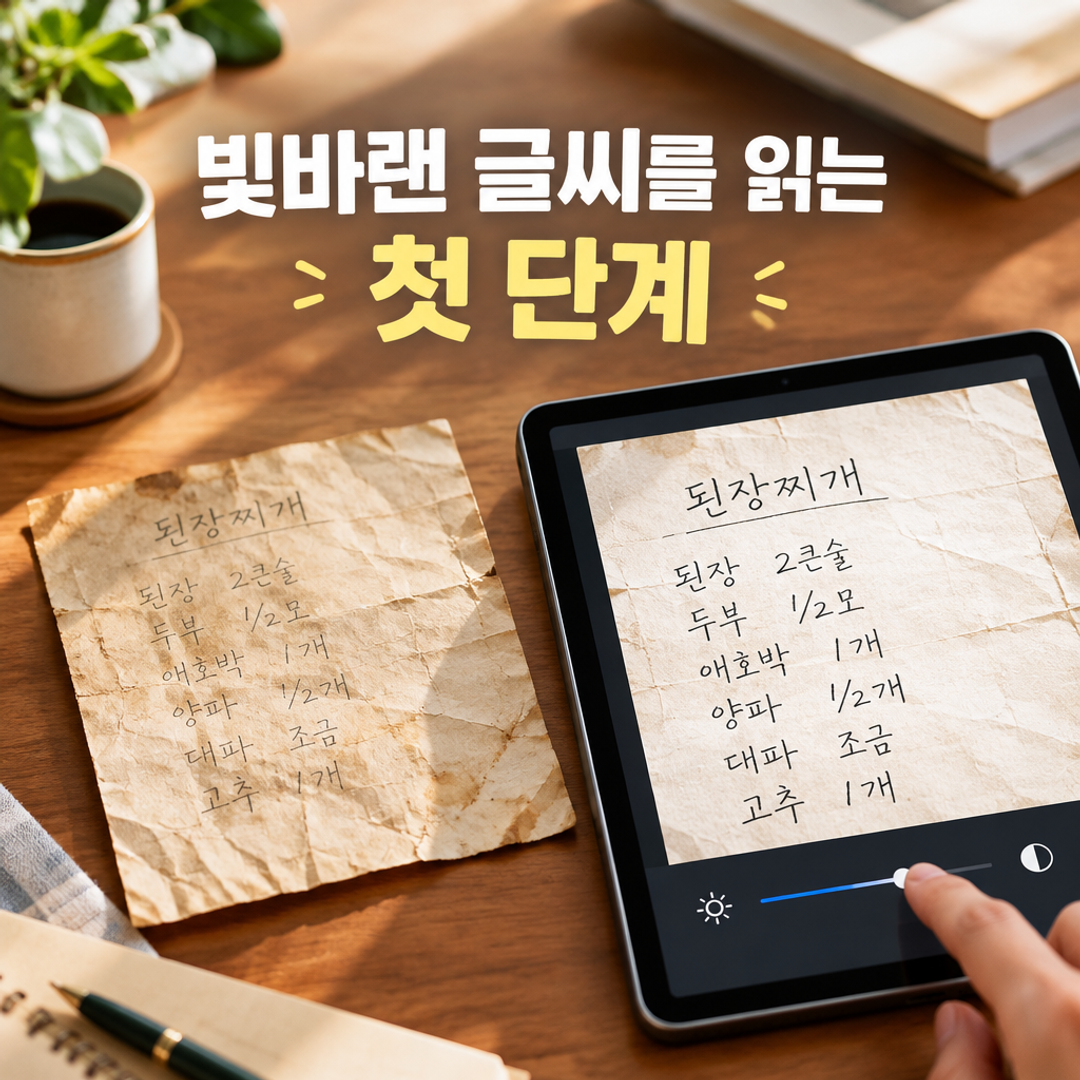
먼저 사진의 기울기를 바로잡고, 밝기와 대비를 조절합니다. 배경의 얼룩이나 종이의 그림자를 줄이고 글자가 잘 보이도록 흑백에 가깝게 만들기도 합니다. 오래된 레시피라면 뒷면의 잉크가 비치거나 음식물이 묻은 흔적이 있을 수 있는데, 이때 보정이 글자를 선명하게 만들기도 하고 반대로 중요한 획을 지워버리기도 합니다.
그다음 글자가 있는 영역과 줄의 위치를 찾습니다. 활자처럼 모양이 일정한 문서는 비교적 읽기 쉽지만, 손글씨는 사람마다 획의 방향과 간격이 다릅니다. 같은 사람이 쓴 글자라도 빠르게 적었는지, 잉크가 번졌는지에 따라 모양이 달라집니다.
손글씨를 인식하는 기술은 일반적인 OCR과 구분해 HTR, 즉 필기체 문자 인식이라고 부르기도 합니다. 하지만 이름이 무엇이든 결과는 이미지의 상태와 글씨체, 사용된 언어와 비슷한 자료를 얼마나 학습했는지에 영향을 받습니다. AI가 글자를 ‘보았다’고 해서 언제나 정확히 ‘읽은’ 것은 아닙니다.
번진 글자는 정답이 아니라 후보를 만든다
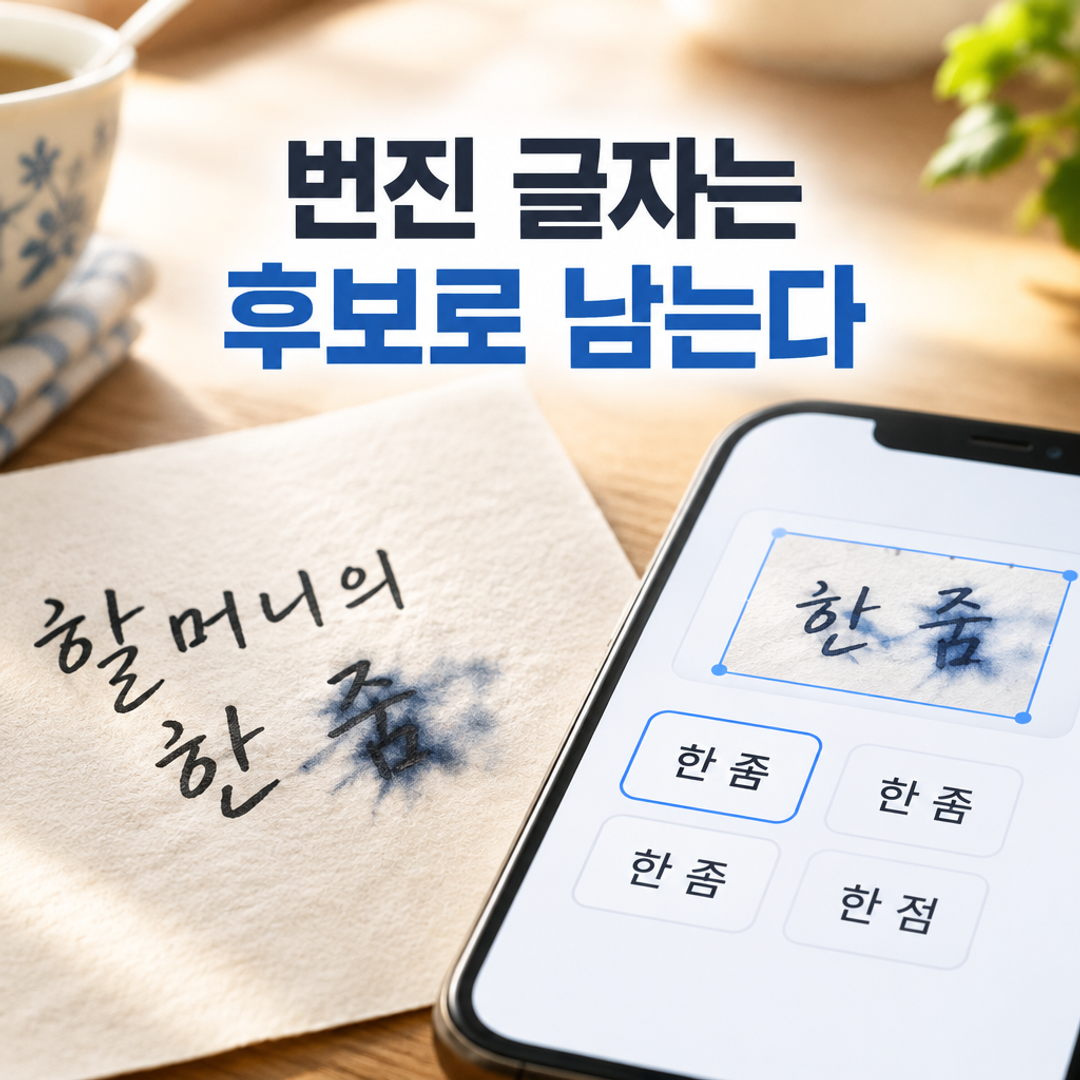
빛바랜 레시피에서 특히 어려운 부분은 글자의 경계가 무너진 곳입니다. 잉크가 번지면 두 글자가 하나처럼 붙어 보일 수 있고, 얼룩이 획처럼 인식될 수도 있습니다. 반대로 실제 획 일부가 사라지면 한 글자가 다른 글자로 바뀌어 읽힐 가능성도 있습니다.
숫자와 단위도 조심해야 합니다. ‘1’처럼 보이는 획이 한글의 일부일 수 있고, ‘큰술’이나 ‘작은술’처럼 짧은 단어는 얼룩이나 줄바꿈에 묻히기 쉽습니다. 오래된 문서라면 오늘날에는 잘 쓰지 않는 표기나 당시의 맞춤법이 남아 있을 수도 있습니다. 이를 AI가 익숙한 현대어로 바꾸면 읽기 편해질 수는 있지만, 원본을 그대로 옮긴 전사와는 다른 결과가 됩니다.
AI는 여러 문자 후보 가운데 주변의 줄 배열이나 자주 등장하는 단어를 참고해 가장 가능성이 높다고 판단한 문장을 내놓을 수 있습니다. 예를 들어 조리법의 앞뒤에 재료 이름이 이어진다면, 그 문맥이 후보를 고르는 데 영향을 줄 수 있습니다.
다만 이것을 ‘요리법을 이해해 빈칸을 완벽하게 복원했다’고 말하기는 어렵습니다. 생성형 AI까지 함께 사용하면 문장이 더 자연스럽게 다듬어질 수 있지만, 자연스러운 문장과 원본에 실제로 적힌 문장은 서로 다를 수 있습니다. 화면에 매끄럽게 출력된 문장일수록 오히려 원본과 대조해야 하는 이유입니다.
‘한 줌’은 번역할 수 없는 생활의 단위
그렇다면 AI가 “소금 한 줌”을 읽었다고 해봅시다. 이 표현을 몇 그램으로 바꾸면 될까요?
정해진 답을 찾기는 어렵습니다. 한 줌은 재료의 종류뿐 아니라 손의 크기, 재료의 상태, 가족의 입맛, 냄비의 크기와 불의 세기까지 함께 전제하는 말이기 때문입니다. “적당히” 역시 요리를 처음 해보는 낯선 사람을 위한 설명이라기보다, 같은 부엌에서 여러 번 음식을 만들어본 사람끼리 통하는 표현에 가깝습니다.
그래서 ‘한 줌’을 자동으로 특정한 무게로 환산하거나 ‘적당히’를 정확한 숫자로 바꾸는 것은 글자를 읽는 일이 아니라 별도의 추정입니다. 그 추정이 실제 가족의 조리법과 맞을 수도 있지만, 원본에 없는 정보를 덧붙인 것일 수 있습니다.
이런 표현은 불완전한 기록인 동시에 중요한 생활 정보이기도 합니다. 레시피를 적은 사람이 어떤 손동작으로 음식을 만들었는지, 누구에게 설명하려 했는지, 당시 부엌에서 무엇이 익숙했는지를 보여주기 때문입니다. 옛 조리서 역시 낯선 독자를 위한 표준 매뉴얼이라기보다 집안의 살림법과 경험을 전하는 기록에 가까운 경우가 있습니다.
가장 안전한 방법은 세 겹으로 남기는 것
가족의 레시피를 디지털로 보관할 때는 결과 문장 하나만 저장하지 않는 편이 좋습니다.
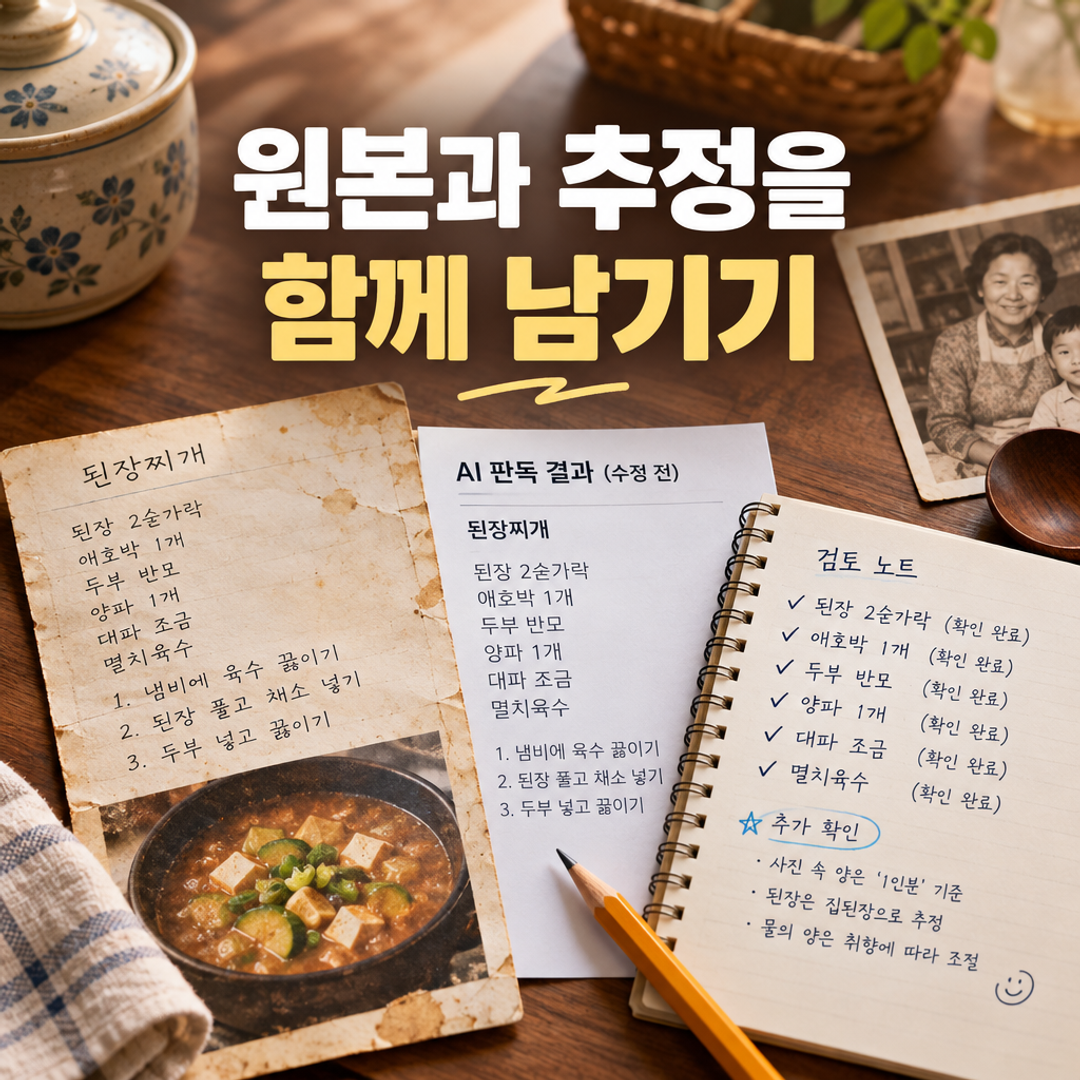
첫째는 촬영한 원본 이미지입니다. 가능하면 보정 전 사진이나 스캔 파일을 그대로 보관해야 합니다. 둘째는 AI나 OCR이 처음 출력한 기계 판독문입니다. 맞춤법을 고치거나 문장을 매끄럽게 다듬기 전의 결과를 따로 남겨두는 것입니다.
셋째는 사람이 원본과 대조한 검토본입니다. 확실하지 않은 글자는 억지로 확정하지 않고 [판독 불가], [소금?]처럼 표시할 수 있습니다. 나중에 다른 가족이 원본을 보고 기억을 보탤 수도 있습니다.
프로그램이 보여주는 신뢰도 점수도 참고 자료일 뿐입니다. 점수가 높다고 해서 역사적 사실이나 가족의 기억까지 정확하다는 뜻은 아닙니다. 실제 기록기관들도 기계가 만든 추출문을 검색과 초벌 전사에 활용하면서, 최종적으로는 사람이 원본 이미지를 보고 수정·확인하는 방식을 사용합니다.
AI는 빛바랜 종이 위의 흔적을 다시 살펴볼 수 있게 해주는 유용한 도구입니다. 하지만 AI가 과거를 그대로 되살리는 것은 아닙니다. 남아 있는 획과 줄의 모양, 주변 단어를 바탕으로 가능한 답을 제시할 뿐입니다. 사라진 부분까지 확실하게 알고 있는 것은 아니지요.
그러니 할머니의 레시피를 디지털로 옮길 때는 완벽한 정답을 얻으려 하기보다, 무엇이 원본이고 무엇이 추정인지 함께 남기는 것이 좋겠습니다. “한 줌”이라는 말도 그대로 보존해보세요. 그 안에는 숫자로 바꾸기 어려운 한 사람의 손 크기와 부엌의 기억이 들어 있을 테니까요.
혹시 집 안 서랍이나 오래된 수첩에 빛바랜 레시피가 남아 있다면, AI에게 읽혀보기 전에 원본 사진부터 한 장 남겨두는 것. 가족의 맛을 기록하는 일은 어쩌면 그 작은 확인에서 시작됩니다.
- 미국 국립문서기록관리청, Frequently Asked Questions
- 미국 의회도서관, Paleography: Interpreting Handwriting in Genealogical Research
- Microsoft Learn, Capabilities and limitations of OCR
- Tesseract OCR, ImproveQuality
- 국립민속박물관 한국민속대백과사전, 반찬등속