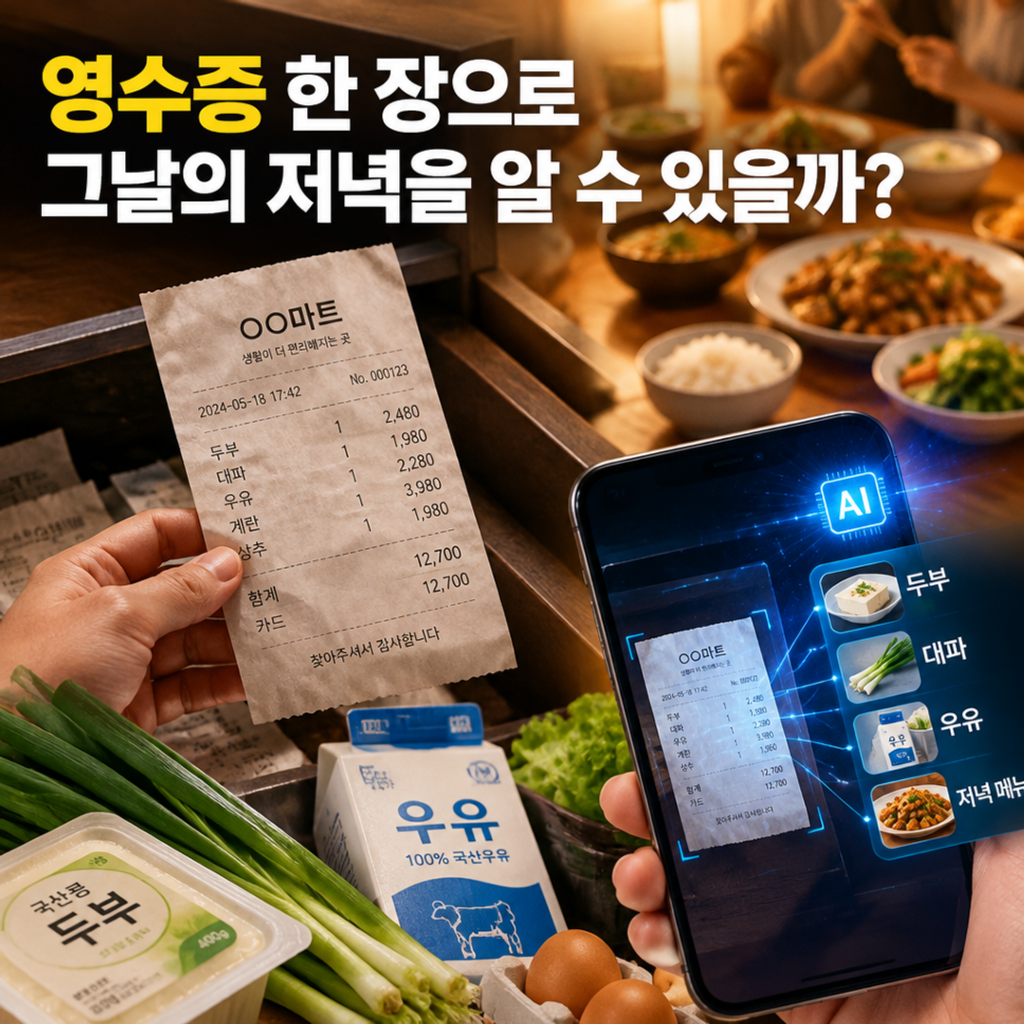
서랍을 정리하다 보면 오래된 영수증 한 장이 툭 떨어질 때가 있습니다. 종이는 누렇게 변했고, 글자는 군데군데 흐려졌지만 ‘두부’, ‘대파’, ‘우유’ 같은 단어가 어렴풋이 보입니다. 그날 저녁 식탁에 올라온 찌개와 반찬이 떠오르고, 누가 장을 보러 갔는지도 생각납니다. 그렇다면 AI에게 이 영수증을 보여주면, 정말 그날의 저녁과 가족의 생활까지 알아낼 수 있을까요?
서랍 속 영수증을 AI에게 보여주면
가상의 장면을 떠올려보겠습니다. 가족이 오래된 영수증들을 한데 모아 사진을 찍고, AI에게 “날짜와 품목을 정리해줘”라고 요청합니다.
AI는 먼저 사진 속 영수증 부분을 찾아냅니다. 기울어진 각도를 바로잡고, 주변 식탁이나 서랍 배경을 잘라냅니다. 어두운 부분을 밝게 하거나 글자와 배경의 대비를 높이는 과정도 거칩니다.
그다음 영수증에 찍힌 글자를 읽습니다. 날짜, 매장 이름, 상품명, 수량, 가격, 합계금액처럼 줄마다 놓인 정보를 구분하는 것입니다. 이후 ‘대파 1단’, ‘세탁세제’, ‘생수’처럼 읽힌 항목을 식재료, 음료, 세제, 위생용품 등의 범주로 나눌 수 있습니다.
이 과정 전체가 모두 생성형 AI로 이뤄지는 것은 아닙니다. 사진을 보정하는 영상처리, 글자를 읽는 OCR, 줄과 숫자의 위치를 해석하는 문서 분석, 상품명을 분류하는 데이터베이스와 규칙이 함께 작동합니다. 우리가 편리하게 “AI가 영수증을 읽었다”고 부르는 일은 여러 기술이 이어진 결과에 가깝습니다.
읽힌 ‘두부’가 정말 두부일까
영수증의 상품명은 일반적인 이름과 조금 다를 수 있습니다. 매장 시스템에 따라 브랜드명이나 용량이 생략되고, 짧은 코드나 축약어만 찍히기도 합니다. AI는 이 글자를 상품 데이터베이스와 대조해 가장 가까운 정식 상품명을 찾습니다.
예를 들어 영수증에 짧게 표시된 상품명이 데이터베이스 속 특정 채소나 가공식품으로 연결될 수 있습니다. 이렇게 하면 ‘식품’, ‘생활용품’, ‘주방용품’ 같은 분류표를 만들고, 한 달 동안 무엇을 자주 샀는지도 정리할 수 있습니다.
하지만 여기에는 중요한 차이가 있습니다. 원문에 실제로 적힌 글자를 읽는 것과, 흐릿한 글자를 바탕으로 가장 그럴듯한 상품을 추정하는 것은 같은 일이 아닙니다.
오래된 영수증에서는 ‘8’과 ‘3’, ‘0’과 ‘6’, 상품명의 비슷한 글자가 서로 바뀔 수 있습니다. 수량의 소수점이 사라지거나 가격 숫자가 다르게 인식될 수도 있습니다. AI가 빈칸을 자연스럽게 채웠다고 해서, 그것이 원래 문자를 정확히 복원했다는 뜻은 아닙니다.
따라서 결과를 볼 때는 ‘영수증에서 직접 읽은 내용’과 ‘상품 데이터베이스를 참고해 분류한 내용’을 나눠 보는 것이 좋습니다.
빛바랜 이유는 잉크가 사라져서가 아니다
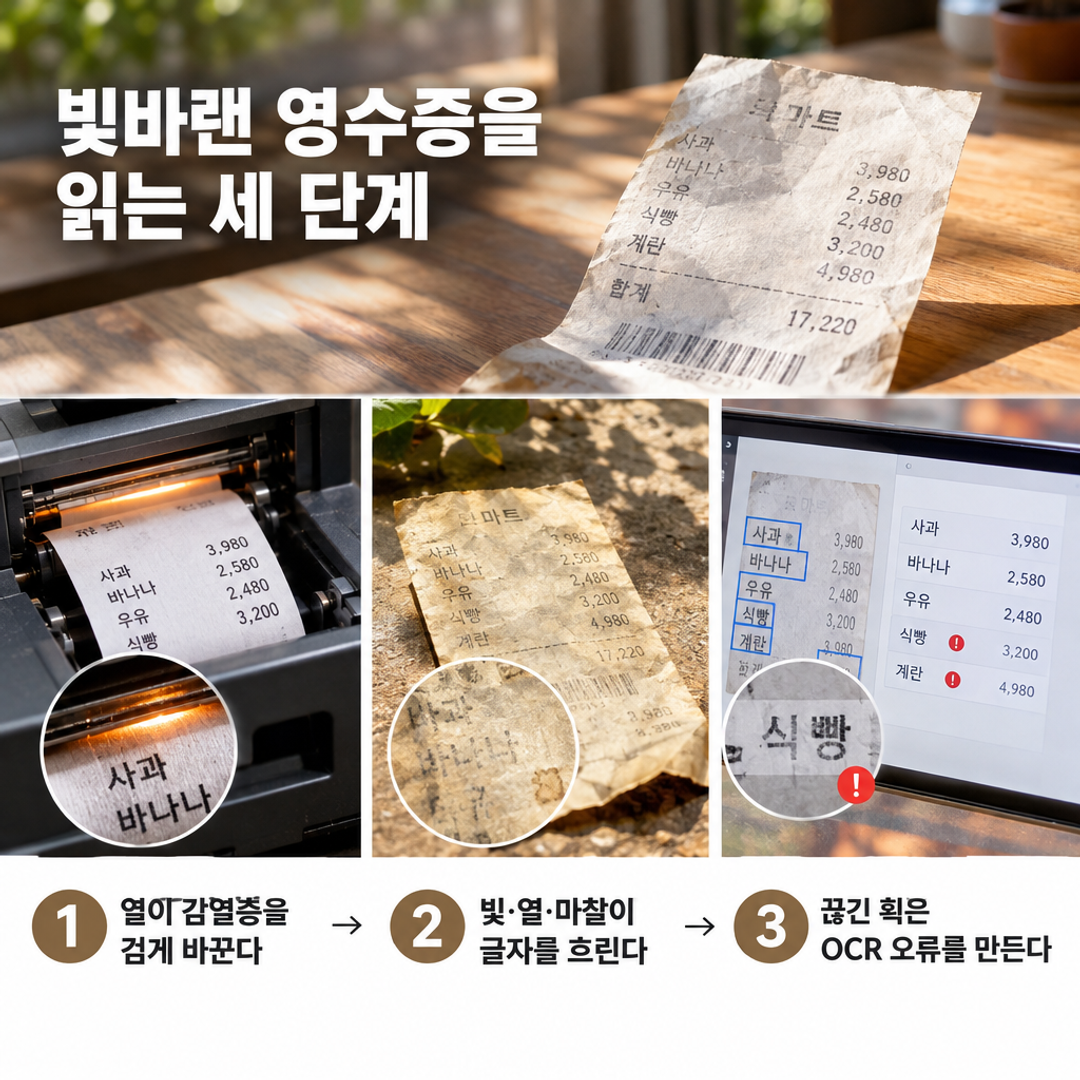
마트 영수증 대부분은 잉크를 종이에 묻히는 방식이 아니라 감열지에 인쇄됩니다. 프린터의 열이 종이 표면에 닿으면 화학 반응이 일어나 검은 글자가 나타나는 방식입니다.
그래서 시간이 지나면 잉크가 단순히 닳아 없어지는 것과는 조금 다른 변화가 생깁니다. 햇빛과 자외선, 높은 온도, 습기, 마찰의 영향을 받아 글자가 흐려지거나 종이 전체가 누렇게 변할 수 있습니다. 자동차 안처럼 덥고 햇빛이 강한 곳에서는 판독이 더 어려워질 수 있습니다.
접힌 자국이나 구김도 문제입니다. 문자 획이 끊기고, 표면이 눌리거나 긁히면서 원래 없던 검은 자국이 생기기도 합니다. 얇은 영수증은 뒷면의 인쇄가 비쳐 사진 속 잡음이 되기도 합니다.
이런 상태에서 OCR이 읽어낸 결과에는 실수가 섞일 수밖에 없습니다. 사진을 다시 밝게 찍거나 여러 각도에서 확인하는 것이 도움이 되지만, 모든 글자를 완벽하게 되살릴 수 있다는 보장은 없습니다. 영수증마다 종이의 성질과 보관 환경이 달라 변색 속도도 같지 않습니다.
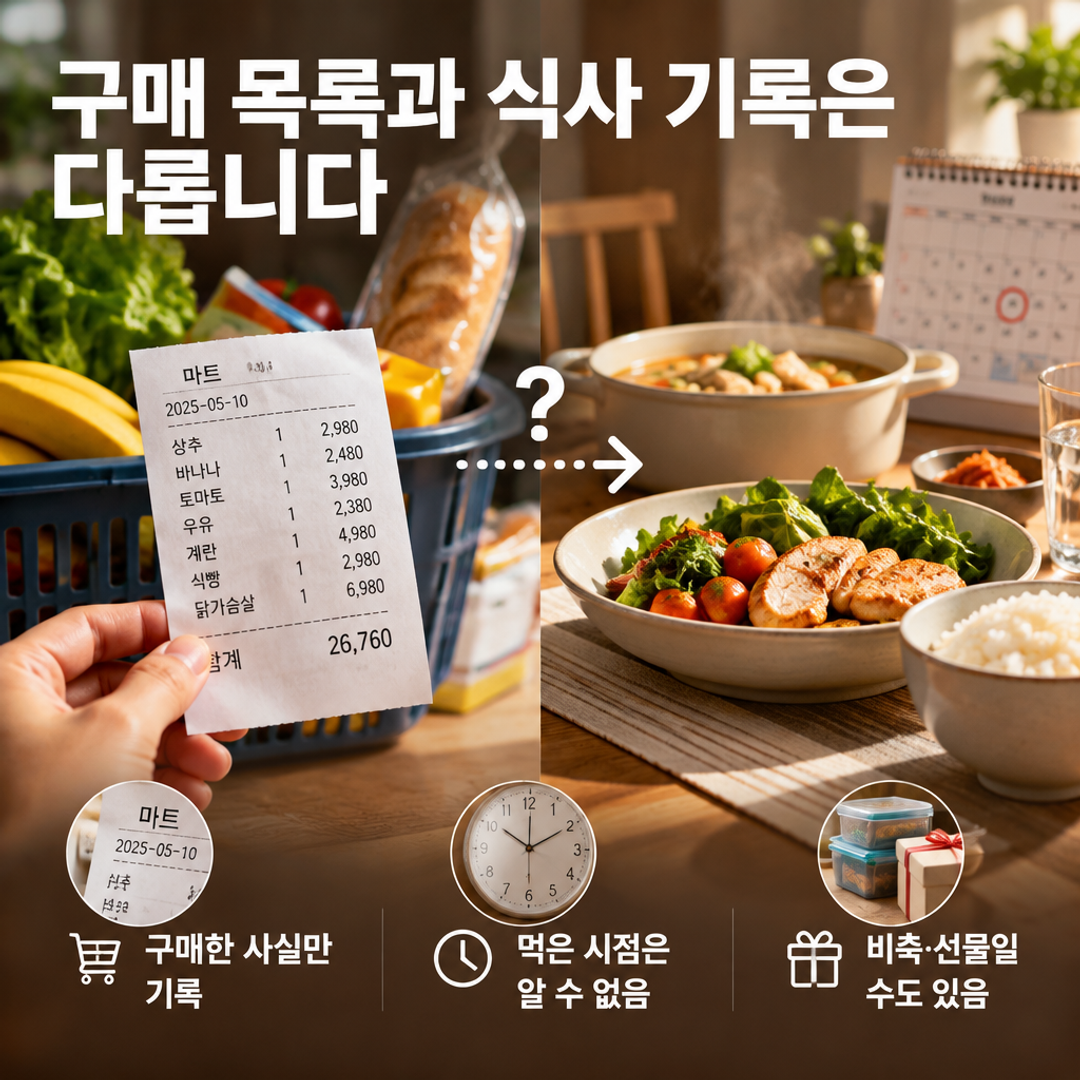
장보기 목록은 식사 일지가 아니다
AI가 ‘두부, 대파, 달걀, 돼지고기’를 찾아냈다고 해보겠습니다. 우리는 자연스럽게 그날 저녁에 두부찌개나 제육볶음을 먹었을지 상상하게 됩니다.
그런 추정은 기억을 되살리는 데 도움을 줄 수 있습니다. 하지만 그것이 실제 저녁 메뉴였다고 단정할 수는 없습니다. 식재료를 다음 날 먹었을 수도 있고, 냉장고에 넣어 두었다가 한참 뒤 사용했을 수도 있습니다. 가족 중 한 사람이 장을 봤지만 다른 사람이 먹었을 가능성도 있습니다. 선물이나 비축을 위해 산 물건일 수도 있습니다.
우유와 빵이 함께 있다고 해서 아침 식사였다고 할 수 없고, 세제와 휴지를 샀다고 해서 그 집의 가족 구성이나 생활 형편을 알아낼 수도 없습니다. 수량 역시 실제로 몇 명이 먹었는지, 몇 끼에 걸쳐 소비했는지와 일치하지 않습니다.
영수증은 ‘그때 무엇을 샀는가’를 보여주는 기록입니다. ‘무엇을 먹었는가’, ‘누가 사용했는가’, ‘어떤 하루를 보냈는가’는 다른 기억과 자료가 있어야 비로소 가까이 다가갈 수 있습니다.
그래서 AI의 역할은 정답을 선언하는 데 있기보다, 가능한 장면을 조심스럽게 펼쳐 보이는 데 있습니다. “그날 저녁은 이것이었다”가 아니라 “이런 식사를 준비했을 가능성이 있다”는 식으로 읽어야 합니다.
추억을 저장할 때 함께 지켜야 할 것
영수증을 디지털로 보관하면 편리합니다. 날짜별로 장보기 기록을 검색할 수 있고, 자주 산 식품이나 생활용품을 한눈에 확인할 수도 있습니다. 가족의 살림을 돌아보는 작은 생활 아카이브가 되는 셈입니다.
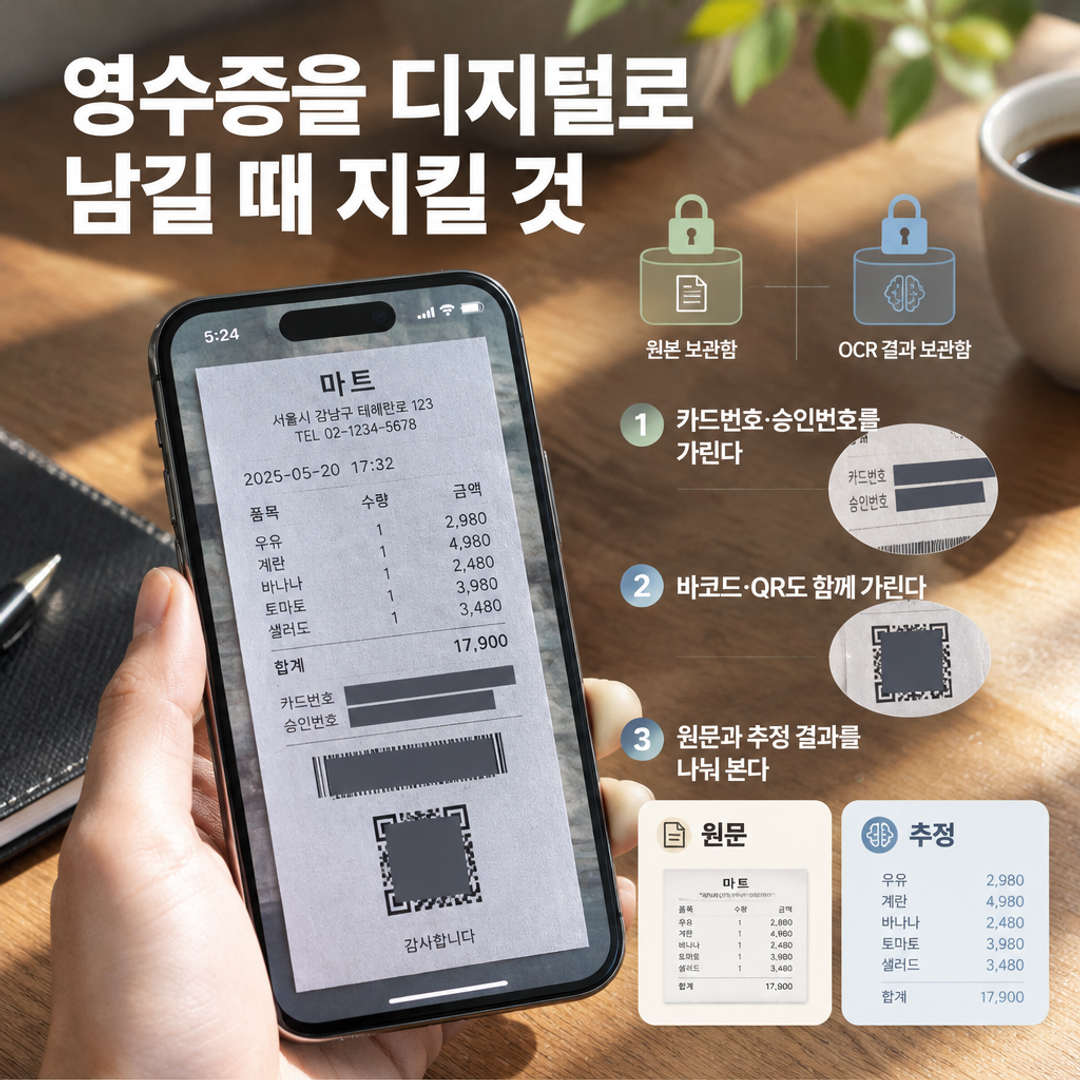
다만 사진을 클라우드나 공개 게시판에 올릴 때는 결제 관련 정보를 먼저 살펴야 합니다. 영수증에는 카드번호 일부, 승인번호, 회원번호, 매장 위치와 구매 시각, 쿠폰이나 할인 정보가 포함될 수 있습니다. 각각은 일부 정보처럼 보여도 다른 기록과 합쳐지면 특정 사람이나 가구를 짐작하게 하는 단서가 될 수 있습니다.
공유할 목적이라면 카드번호, 전화번호, 회원번호, 주소, 승인번호, 바코드와 QR코드는 가리는 편이 안전합니다. 흐림 효과만 사용하는 것보다 해당 부분을 불투명하게 덮고, 원본 사진과 OCR 결과의 접근 권한도 나누는 것이 좋습니다. 날짜와 매장 정보 역시 꼭 필요한 범위만 남기는 것이 바람직합니다.
빛바랜 영수증 한 장은 완벽한 증거가 아닙니다. 그러나 그 안에는 장을 본 계절, 자주 사던 물건, 잊고 있던 식탁의 분위기를 떠올리게 하는 작은 단서가 있습니다. AI는 그 단서를 빠르게 정리해줄 수 있지만, 빈틈을 기억으로 메우는 일은 결국 사람의 몫입니다.
영수증 속 ‘대파 한 단’이 정말 그날의 찌개였는지는 알 수 없을지 모릅니다. 그래도 그 한 줄을 바라보다 문득 떠오른 저녁의 냄새와 식탁의 목소리만큼은, 숫자와 상품명만으로는 기록되지 않는 우리의 생활일 것입니다.
arxiv.org, 「ICDAR2019 Competition on Scanned Receipt OCR and Information Extraction」
https://arxiv.org/abs/2103.10213
anixter.com, 「WHITE PAPER」
https://www.anixter.com/content/dam/Suppliers/Brother/White%20Papers/ThermalPaperWhitePaper%20%28WP1%29.pdf?utm_source=openai
fim.uni-passau.de, 「Optical Character Recognition for supermarket receipts」
https://www.fim.uni-passau.de/fileadmin/dokumente/fakultaeten/fim/lehrstuhl/sauer/geyer/BA_MA_Arbeiten/BA-ZiegausMarco-201607.pdf?utm_source=openai
arxiv.org, 「Understanding Scanned Receipts」
https://arxiv.org/abs/2005.01828
nvlpubs.nist.gov, 「De-Identifying Government Datasets: Techniques and Governance」
https://nvlpubs.nist.gov/nistpubs/SpecialPublications/NIST.SP.800-188.pdf